Bayesian Inference with MCMC
업데이트중…
MCMC
우리는 본 내용에서 왜 MCMC가 효과적인 샘플링 방법인것인지 대해서 확인 할 것이며, 실제 예제를 통하여 왜 베이지안 추론과 연관이 되는지 확인 할 수 있을 것이다.
생각보단 많은 공식이 나온다. 하지만 해당 공식은 기본적인 수식이다.
따라서 충분히 이해 할 수 있기에 너무 겁을 먹지 말자.
Markov Chain Monte Carlo이란?
MCMC는 확률 분포에서 샘플링하는 기술 중 하나이며 관찰된 일련의 값으로부터 매개 변수 분포를 추정하는 데 사용.
우리는 그중 Metropolis-Hastings algorithm 기법에 대해서 알아보고자 한다.
그리고 해당 기법이 왜 베이지안 추론에서 중요한 기법인지 실제 사용 예제 및 공식을 나열하여 설명하고자 한다.
그에 앞서 우리는 먼저 간단하게 베이즈 정리 및 샘플링에 대해서 설명을 하고자한다.
Frequentist vs Bayesian thinking
빈도주의
빈도주의자의 관점에서 확률은 사건이 발생하는 장기적인 빈도를 나타낸다.
빈도주의자는 동전 던지기에서 앞면과 뒷면이 나올 확률이 장기적으로 0.5로 같다고 말한다.
각각의 새로운 실험은 동일한 실험이 무한히 반복될 수 있는 시퀀스 중 하나로 간주할 수 있다.
즉, 빈도주의자의 확률에 대한 관점에는 믿음이 없다는 것입니다.
사건 X의 확률 가 n번의 시도 중 발생할 확률은 다음과 같은 빈도와 같습니다: $(P(x)=\frac{n_x}{n})$이며, 실제 확률은 n->∞일 때 도달한다.
중요한 점은 반복으로 장기적인 확률.
빈도주의자들은 “오늘 점심에 파스타가 나올 확률이 45%(0.45)라고 확신한다.”고 말하지 않는다.
왜냐하면 이런 일은 장기적으로 일어나지 않기 때문이다.
일반적으로 빈도주의적 접근 방식은 믿음 및/또는 이전 사건에 대한 표현이 없기 때문에 객관적 접근 방식이라고 한다.
베이지안
반면에 베이지안 사고에서는 확률을 신념의 표현으로 취급한다. 따라서 베이지안에게 “오늘 점심에 파스타가 있을 확률이 50%(0.5)이다”라고 말하는 것은 지극히 합리적이다. 이전 신념과 현재 사건(증거)을 결합하여 후행(사후) 신념, 즉 오늘 파스타가 있을 것이라는 신념을 계산할 수 있다. 베이지안 사고의 기본 개념은 더 많은 증거가 제공됨에 따라 신념을 계속 업데이트하는 것이다.
이 접근 방식은 신념을 다루기 때문에 일반적으로 확률에 대한 주관적 관점이라고 한다.
즉, 빈도론자는 확률에 대해 사건이 일어나는 장기적인 확률로써 오로지 경험적 사실만을 통해 이야기할 수 있다는, 객관적인 입장이고 베이지안은 지식이나 판단의 정도를 나타내는 수단으로써, 주관적인 입장을 취한다.
베이지안 추론
토마스 베이의 추상화(상상도로 추정)
의사 결정 철학에서 베이지안 추론은 prior(사전 확률), Evidence(증거), Likehood(우도)을 활용하여 Posteror(사후 확률)를 계산한다는 점에서 베이지안 확률과 밀접한 관련이 있다.
대응되는 공식은 식(1), (2) 와 같다.
식 (2)은 실제 데이터로 파라미터를 추정한다는 의미로 많이 사용되는 부분이다. 단 보이듯이 식 (1)과 (2)은 차이는 없다.
\[\begin{align} P(H\mid E) = \frac{P(E\mid H) P(H)} {P(E)} \end{align}\] \[\begin{align} P(\theta \mid Data) = \frac{P(Data\mid \theta) P(\theta)} {P(Data)} \end{align}\] \[\begin{align} P(\theta \mid Data) \propto P(Data\mid \theta) P(\theta) \end{align}\]우리는 가장 가능성이 높은 $\theta$(데이터를 설명하는 모델의 파라미터)의 분포를 찾고자 한다.
이러한 확률 중 일부를 계산하는 것은 지루할 수 있으며, 특히 증거 $P(D)$ . 또한, 이 글에서는 다루지 않을 접합성(?) 보장 문제와 같은 다른 문제도 발생할 수 있습니다.
다행히도 MCMC와 같은 일부 기법을 사용하면 증거 계산이나 Conjugacy(공액)에 대해 걱정할 필요 없이 사후에서 표본을 추출하고 매개변수에 대한 분포를 그릴 수 있다.
일련의 관측치와 사전 신념이 주어졌을 때 매개변수 분포를 계산하거나 고차원 적분을 계산하는 등 많은 애플리케이션에서 많은 성공을 거두었다.
결론은 다음과 같다: 일련의 관측값과 사전 신념이 주어졌을 때 매개변수에 대한 분포를 계산하는 데 사용할 수 있다.
몬테 카를로 의미: Sampling!
MCMC는 직접적으로 샘플링할 수 없는 모든 분포에서 샘플을 추출할 수 있게 한다.
파라미터에 대한 사후 분포에서 샘플링하는 데 사용될 수 있음.
Sampling
우리는 $g(x)$의 Expected value(기댓값)을 계산한다고 하자, 해당 계산은 다음 식으로 정의 할 수 있다. $p(x)$는PDF.
\[\begin{align} \mathbb{E}[g(x)] = \int_{-\infty}^{\infty} g(x)p(x)dx\end{align}\]예를들어, $g(x) = x^2$이며 $X \sim p(x)$라고 해도 식(4)는 구하기 어렵다.
그렇다면 우리는 어떤 방법을 사용하여 우회적으로 해결 할 수 있을까? → $X \sim p(x)$에서 $x$를 샘플링하여 식(4)을 우회하여 계산하자.
\[\begin{align} \mathbb{E}[g(x)] = \frac{1}{N}\sum_{i=1}^{N}g(x_i) \end{align}\]그렇다면 어떻게 하면 $x_i \sim p(x)$ 만족하는 $x_i$을 샘플 할 수 있을까?
우리는 먼저 기본적인 샘플링 방법론을 배울 것이며 최종적으로 MCMC 방안이 왜 제안되었는지 배울것이다.
Inverse Transform Sampling
먼저 $p(x)$의 Cumulative distribution function(CDF) 을 구한다.
\[\begin{align} F(x) = \int_{-\infty}^{x} p(t) dt \end{align}\]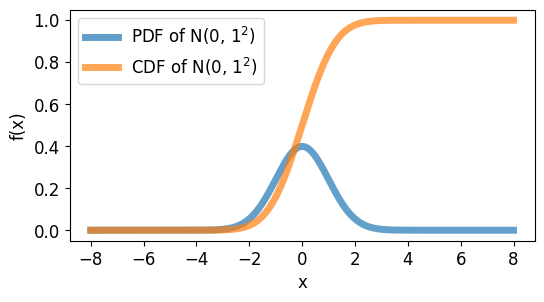
우리는 확률누적함수의 출력값 범위가 [0, 1] 인 것을 알고 있다.($\because$확률이기에)
만약 우리가 $F(x)$을 알고 있다면 역함수 $F^{-1}(x)$을 구할 수 있을 것이다.
그렇다면 $y_i \sim U(0, 1)$에서 랜덤적으로 $y_i$을 샘플한다면 대응되는 $x_i(x_i = F^{-1}(y_i))$을 구할 수 있을것이다.
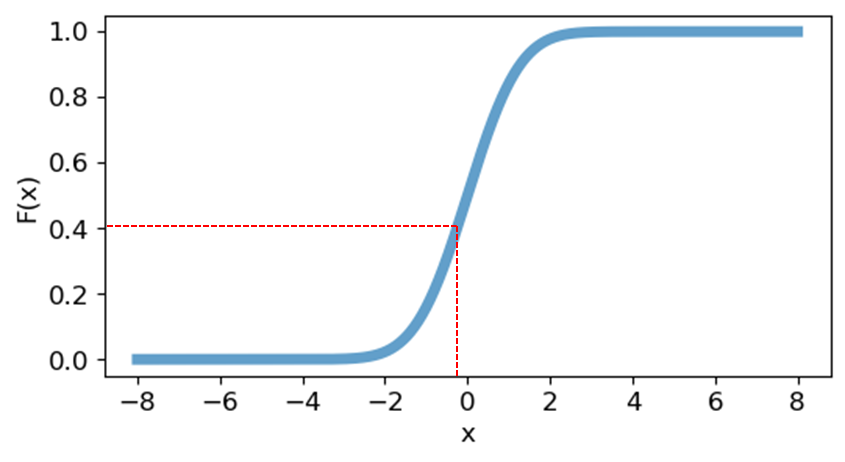
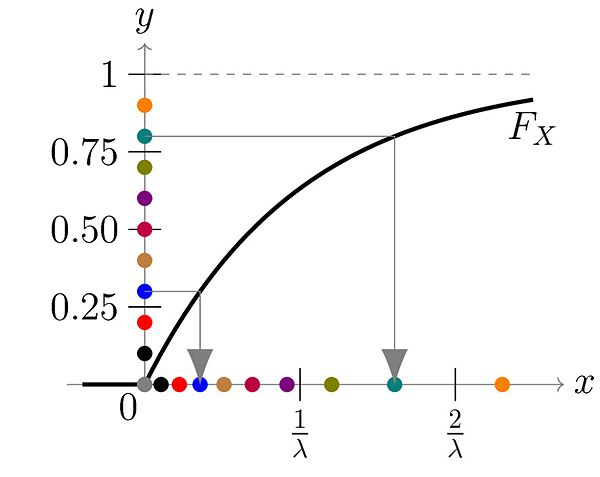
따라서 우리는 $X \sim p(x)$을 샘플을 우회적으로 구할 수 있다!
하지만 $F(x)$는 정말 구하기 쉬울까?
아쉽지만 수식적으로 누적함수는 구하기는 생각보다 어려우며 만약 파라미터가 많아진다면 해당 수식은 닫힌 형태가 아니기에 구할 수가 없다.
Rejection Sampling
만약 분포가 다음 그림과 같다면 CDF를 구하기 어려울 것이다.
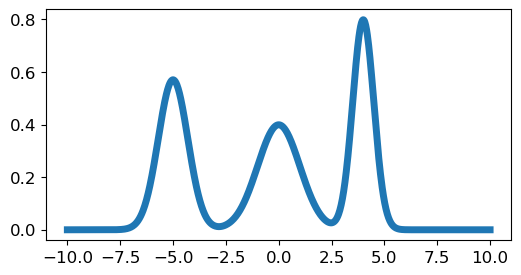
그렇다면 적분 함수를 구하기 쉬운 제안 함수 $mq(x)$를 사용하여 우회적인 방법으로 구하자.
제안 함수는 다음 두 가지를 만족 조건 만족한다.
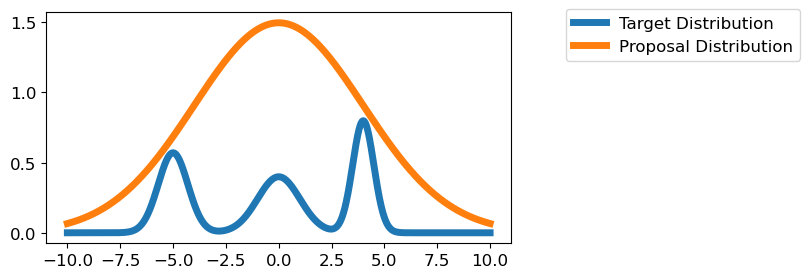
예를 들어 정규분포로 상위와 같은 그림같은 제안 함수를 제안 할 수 있을 것이다.
Inverse Transform Sampling에서 증명했듯이 $q(x)$의 분포도를 쉽게 구할 수 있다.
따라서 제안 함수의 샘플링은 쉽게 할 수 있다.
하지만 우리가 구하는 것은 $q(x)$의 샘플이지, $p(x)$가 아니다.
그러면 구한 샘플 값 중 일부를 일정 확률로 기각(Rejection)한다면 $p(x)$를 구할 수 있지 않을까?
따라서 기각 기법의 알고리즘은 다음과 같다.
Rejection Sampling
- Accept 확률: $p = \frac{f(x)}{mq(x)}$
- $u \sim U(0, 1)$
- $u <= p$, Accept
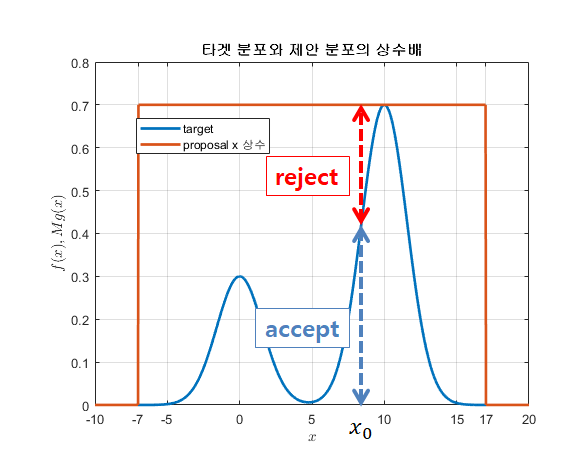
$p = \frac{f(x)}{mq(x)}$ 의미
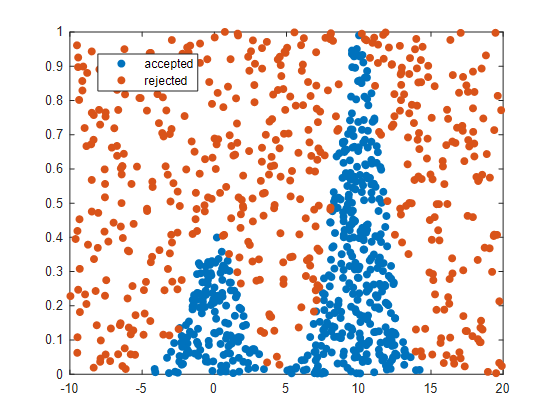
해당 조건으로 추출된 샘플들은 상위 우측 그림과 같으며 Rejection 알고리즘은 다음과 같다.
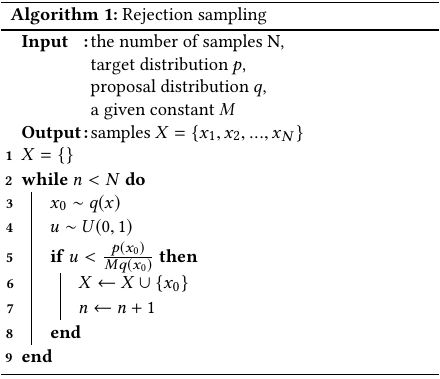
Rejection 알고리즘이 좋아 보이지만 다음과 문제점이 있다.
- 알맞는 $mq(x)$ 구하기가 어렵다. 너무나 큰 분포를 구한다면, 대부분의 샘플들을 기각될것이며 이는 즉 알고리즘이 효율적이지 않다는 의미이다.
- 고차원으로 갈 수록 구하기가 어려워진다.
Markov Chain
MCMC 에서 알 수 있듯이 마코프 체인을 성질을 이용하여 몬테 카를로 시뮬레이션을 진행한다는 것이다.
따라서 간단히 Markov Chain 짚고 넘어가자.
마코프 체인은 성질은 아주 간단하다.
다음 상태는 이전 상태와 무관하며 오로지 현 상태와 연관이 있다는 것이다.
해당 묘사는 다음과 같이 표현 할 수 있다.
\[\begin{align} p(x^{t+1} \mid x^1, x^2, ..., x^t) = p(x^{t+1} \mid x^t)\end{align}\]우리는 mcmc에서 사용될 마코프 체인의 특정 성질(수렴)을 알고 넘어가자.
마코프 체인 실제 예시
해당 성질은 다음 예제로 설명하고자 한다.
다음 그림과 같이 한 사람의 상태($\pi$)는 싱글, 교제, 결혼과 같은 상태를 가지고 있으며 다음 상태는 아래 도표의 전이 확률로 전이가 된다.
일반적으로 상태는 $\pi$ 라고 표기하여 $\pi(i) \rightarrow i\space status$의 분포를 의미한다.
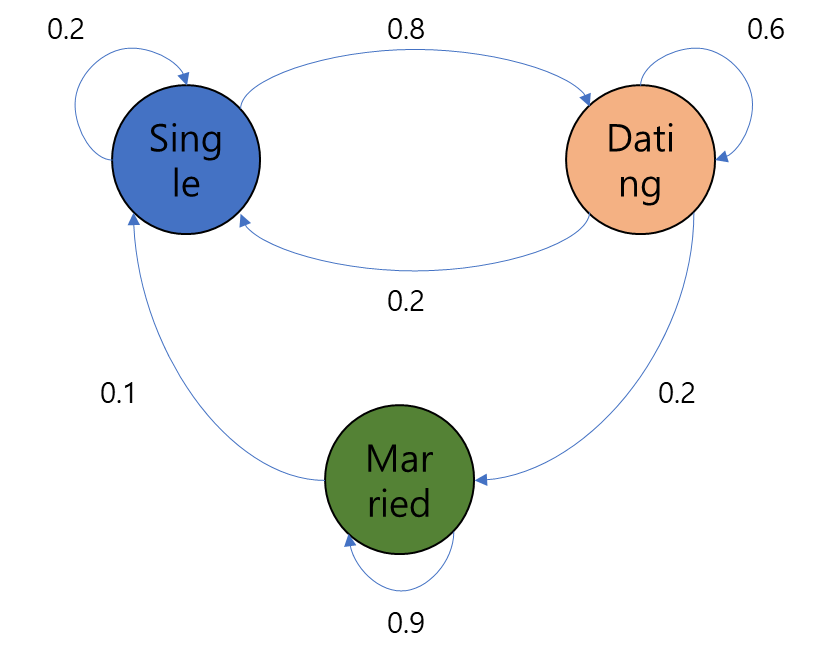
| $P$(전이 확률) | single | dating | married |
|---|---|---|---|
| single | 0.2 | 0.8 | 0.0 |
| dating | 0.2 | 0.6 | 0.2 |
| married | 0.1 | 0.0 | 0.9 |
만약 초기 상태 $\pi(0)$및 $P$를 알고 있다면 우리는 임의의 상태를 알 수 있다.
\[\pi^0 \rightarrow \pi^1 \rightarrow \pi^2 \rightarrow ... \rightarrow \pi^t \rightarrow \pi^{t+1} \rightarrow ... \rightarrow \pi^m \rightarrow ...\]또한 어떤 초기상태이든 어느시점이후부터는 $\pi$는 분포는 변하지 않는다.
만약 $\pi P = \pi$ 이라면 Steady Status(안정상태)라고 말 할 수 있다.
$\pi^m \sim \pi(x)$
이는 다음과 같은 그림으로 확인 할 수 있다.
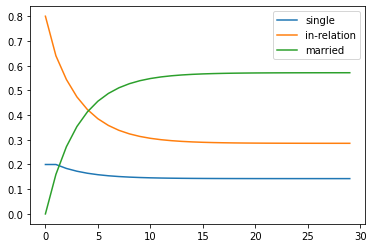
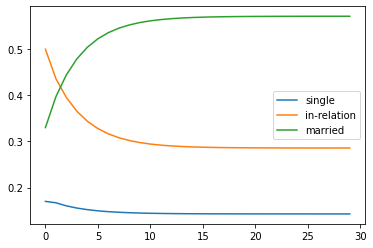
보이듯이 특정 시점부터는 초기 상태가 어떠하든 안정된 분포를 가지게 된다.
즉 $P$ 전이 확률을 알 수 있다면 특정 시점부터는 우리가 구하고자 하는 분포에서 안정하게 샘플링 할 수 있다!
하지만 문제 발생! $P$를 어떻게 구하지?
Detailed Balanced
그렇다면 우리는 먼저 $\pi P = \pi$의 충분 조건인 Detailed Balanced에서 시작하자.
식은 다음과 같다.
\[\begin{align} \pi(i) P(i, j)=\pi(j) P(j, i) \Rightarrow \pi P = \pi\end{align}\]해당 식을 왜 $\pi P = \pi$을 만족하는지는 식 (9) 에서 간단히 증명 가능하다.
\[\begin{align} \sum_{i=1}^{\infty} \pi(i) P(i, j)=\sum_{i=1}^{\infty} \pi(j) P(j, i)=\pi(j) \sum_{i=1}^{\infty} P(j, i)=\pi(j) \end{align}\]MCMC 증명(가장 중요)
여기서 우리는 일단 만약 임의의 전이 매트릭스 $Q$ 을 알고 있다고 하자.
거의 확정적으로 해당 $Q$는 다음 식을 만족할 것이다.
\[\begin{align}\pi(i) Q(i, j) \neq \pi(j) Q(j, i) \end{align}\]그렇다면 우리는 특정 $\alpha$을 곱하여 식(10)을 강제적으로 다음 식을 만족한다고 하자.
\[\begin{align}\pi(i) Q(i, j) \alpha(i, j)=\pi(j) Q(j, i) \alpha(j, i) \end{align}\]그렇다면 우리는 식 (8), (11)을 통하여 다음 식을 얻을 수 있다.
\[\begin{align} P(i, j)=Q(i, j) \alpha(i, j)\end{align}\]그렇다면 $\alpha$는 무엇일까? $\alpha$가 어떤 수식일때, 상위 수식을 만족 할 수 있을까?
$\alpha$를 다음과 같이 정의 한다면 상위식은 만족할 수 있을 것이다.
\[\begin{align} \begin{gathered} \alpha(i, j)=\pi(j) Q(j, i) \\ \alpha(j, i)=\pi(i) Q(i, j) \end{gathered}\end{align}\]그렇다면 $\alpha$의 의미는 일까?
식(13) 에서 보이듯이 $Q$는 전이 확률이며, $\pi$또한 확률이다 따라서 $\alpha$값의 Range는 [0, 1].
즉 $\alpha$는 확률이다.
따라서 식 (12)에서 $Q$는 $\alpha$의 확률로 $P$된다것을 의미.
그렇다면 이것은 이전의 기각 샘플링과 같은 뜻을 의미 한다.
임의의 전이 확률로 샘플링, 그리고 해당 샘플을 $\alpha$ 확률로 accept
그렇다면 기각 샘플링과 무엇이 다르냐?
만약 해당 샘플이 accept이 된다면 해당 상태(샘플)에서 다시 샘플링을 한다.
Improved
식 (13)는 아래와 같은 식으로 치환 할 수 있으며, 해당 식은 기존보다 더 좋게 샘플링 할 수 있다.
\[\begin{align} \alpha(i, j)=\min \left\{\frac{\pi(j) Q(j, i)}{\pi(i) Q(i, j)}, 1\right\} \end{align}\]해당 식은 여전히 식(8)을 여전히 만족한다. 이는 다음 식으로 증명 가능하다.
\[\begin{align} \begin{gathered} \pi(i) Q(i, j) \cdot \min \left(\frac{\pi(j) Q(j, i)}{\pi(i) Q(i, j)}, 1\right)=\min (\pi(j) Q(j, i), \pi (i) Q(i, j)) \\ =\pi(j) Q(j, i) \cdot \min \left(1, \frac{\pi(i) Q(i, j)}{\pi(j) Q(j, i)}\right)=\pi(j) Q(j, i) \alpha(j, i)\end{gathered}\end{align}\]전체 작동 방식은 다음와 같으며 Metropolis-Hastings MC라고 불린다.
- 특정 전이매트릭스 $Q$, 안정상태 $\pi(x)$
- $t=0$의 특정 초기 상태 $x_0$조건분포
for loop
- 조건분포 $Q(x\mid x_0)$에서 $x^*$ 샘플링
- 균일 분포에서 $u \sim U(0, 1)$ 샘플링
- if $u < \alpha{(x_0, x^)} = \min \left{\frac{\pi(j) Q(j, i)}{\pi(i) Q(i, j)}, 1\right}$, then accept $x^ \rightarrow t=1, x_1=x^*$ else reject, $t=1, x_1 = x_0$
- 해당식을 $t>T$ 까지 반복, 안정 상태 도달
이후 모든 샘플 accept
실제 적용
아까 설명한 메트로폴리스-헤이스팅즈(Metropolis-Hastings)는 MCMC의 구체적인 구현 방법 중 하나이다.
기브스 샘플링(Gibbs sampling), NUTS 등 같이 여러 다른 방법 존재한다. 다른 방안은 추후 스터디 예정.
일단 MHMC을 예제와 함께 설명하고자한다.
먼저 우리는 전이 분포 $Q(\theta’ \mid \theta)$를 설정한다. 이는 사후 분포에서 샘플 추출을 돕는다.
메트로폴리스-헤이스팅스는 $Q$ 를 사용하여 분포 공간에서 무작위로 걸으며 샘플의 확률에 따라 새로운 위치로의 이동을 수락하거나 거부한다.
이 “memoriless” random walk는 MCMC의 “마코프 체인” 부분에 해당한다.
각각의 새로운 샘플의 ‘우도’는 함수 $f$에 의해 결정. 따라서 $f$는 무조건 표본을 추출하려는 사후 확률에 비례해야 한다.
일반적으로 이 비례를 표현하는 확률 밀도 함수로 $f$를 선택.
파라미터의 새로운 위치를 얻으려면 현재 위치 $\theta$를 취하고, $Q(\theta’ \mid \theta)$에서 무작위로 추출한 샘플인 새로운 위치 $\theta’$를 제안하면 된다. 대개 symmetric(대칭) 분포 선정한다, 이유는 식이 약분되어 간단해진다.
예를 들어, 평균이 $\theta$, 표준편차가 $\sigma$인 정규 분포 $Q(\theta’ \mid \theta) = \mathcal{N}(\theta, \sigma)$ 사용한다.
$\theta’$를 수락할지 거부할지 결정하려면 $\theta’$의 새로운 값에 대해 확률을 계산해야한다.
우리는 식 (10)에서 대응되는 수식으로 치환하면 된다.(확인 필요)
\[\begin{align} \pi(i) Q(i, j) = P(\theta\mid D) \mathcal{N}(\theta, \sigma) \end{align}\]$\pi(i) = P(\theta’ \mid D)$, $Q(i, j) = \mathcal{N}(\theta, \sigma)$이다
따라서 식(14)의 $\alpha$는 다음과 같다.
\[\begin{align} \alpha(i, j)=\min \left\{\frac{\pi(j) Q(j, i)}{\pi(i) Q(i, j)}, 1\right\} \end{align}\] \[\begin{align} \alpha(i, j)=\min \left\{\frac{P(\theta' \mid D)\mathcal{N}(\theta^\prime, \sigma)}{P(\theta \mid D)\mathcal{N}(\theta, \sigma)}, 1\right\} \end{align}\] \[\because \mathcal{N}(\theta, \sigma) \space is \space symmetric\] \[\begin{align} \alpha(i, j)=\min \left\{\frac{P(\theta' \mid D)}{P(\theta \mid D)}, 1\right\} \end{align}\]우리는 $min$부분 수식에 집중하고자 한다. 식은 다음과 같다.
\[\begin{align} \frac{P(\theta' \mid D)}{P(\theta \mid D)} \end{align}\]베이즈 공식을 사용하면 다음과 같이 쉽게 다시 치환 할 수있다.
\[\begin{align} \dfrac{P(D/\theta^\prime)P(\theta^\prime)}{P(D/\theta)P(\theta)} \end{align}\]우리는 $P(D\mid \theta^\prime)$은 likelihood도 치환 할 수 있다. 따라서 식은 다음과 같다.
\[\begin{align} \dfrac{\prod_i^nf(d_i/\Theta=\theta^\prime)P(\theta^\prime)}{\prod_i^nf(d_i/\Theta=\theta)P(\theta)} \end{align}\]최종적으로 다음과 같은 확률은
\[\begin{align} \begin{equation} \alpha = P(\text{accept}) = \begin{cases}\dfrac{\prod_i^nf(d_i/\Theta=\theta^\prime)P(\theta^\prime)}{\prod_i^nf(d_i/\Theta=\theta)P(\theta)}, & \prod_i^nf(d_i/\Theta=\theta)P(\theta)>\prod_i^nf(d_i/\Theta=\theta^\prime)P(\theta^\prime) \\ 1, & \prod_i^nf(d_i/\Theta=\theta)P(\theta)\leq \prod_i^nf(d_i/\Theta=\theta^\prime)P(\theta^\prime) \end{cases} \end{equation} \end{align}\]즉, $\theta^\prime$가 현재 $\theta$보다 가능성이 높으면 항상 $\theta^\prime$를 수락.
현재 θ보다 가능성이 낮으면 가능성이 낮을수록 무작위로 수락하거나 거부할 확률이 낮아진다.
더미 데이터 예시
자 이제 실제 데이터로 해당 방안을 적용해보자.
데이터 생성
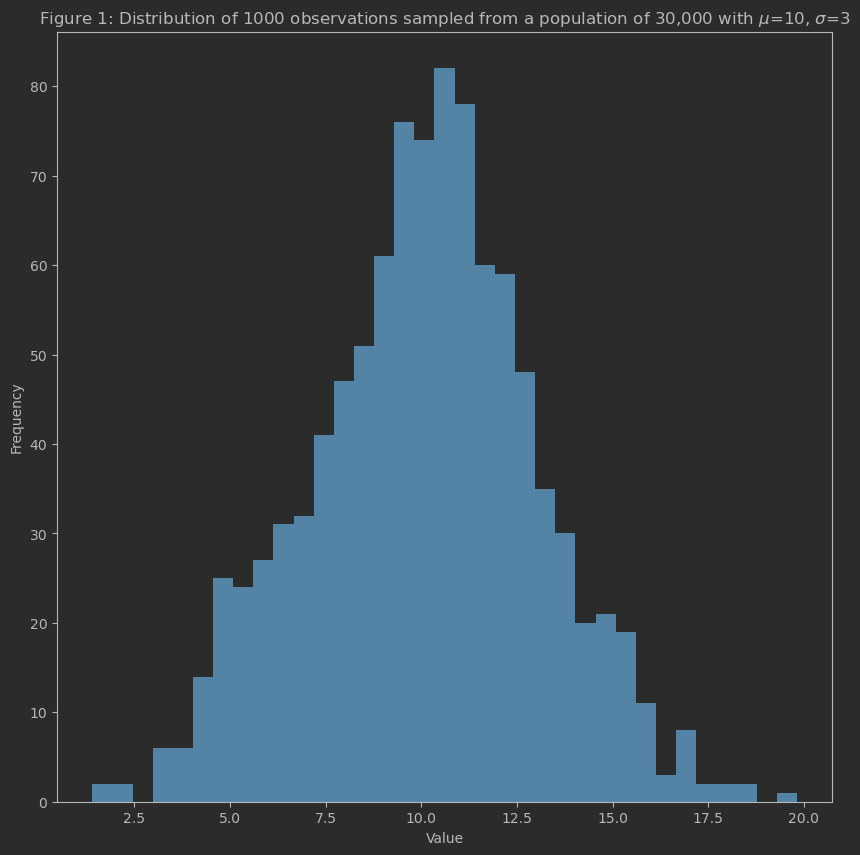
먼저 $\mu = 10, \sigma=3$인 분포에서 3만개 샘플 생성, 단 우리는 그중 1000개만 관측치로 사용.
mod1=lambda t:np.random.normal(10,3,t)

#Form a population of 30,000 individual, with average=10 and scale=3
population = mod1(30000)
#Assume we are only able to observe 1,000 of these individuals.
observation = population[np.random.randint(0, 30000, 1000)]

fig = plt.figure(figsize=(10,10))
ax = fig.add_subplot(1,1,1)
ax.hist(observation,bins=35 ,)
ax.set_xlabel("Value")
ax.set_ylabel("Frequency")
ax.set_title("Figure 1: Distribution of 1000 observations sampled from a population of 30,000 with $\mu$=10, $\sigma$=3")
mu_obs=observation.mean()
mu_obs
우리가 구할 것은?
1000개의 관찰된 샘플을 사용하여 $\sigma$의 분포를 구하고자 한다..
하지만 우리는 표준 편차 계산 방식($\sigma=\sqrt{\dfrac{1}{n}\sum_i^n(d_i-\mu)^2}$)으로 쉽게 계산 할 수 있다.
하지만 실제 문제에서는 직접 계산 할 수 없는 예제가 있으며 또한 여기서는 $\sigma$의 값을 찾는 것이 아니라 $\sigma$의 가능한 값의 분포를 계산하려고 한다.
PDF 및 전이 확률 정의
전이 확률 같은 경우 우리는 간단한 정규 분포를 선택한다.
\[\begin{equation} Q(\sigma_{new} / \sigma_{current}) = N(\mu=\sigma_{current},\sigma'=1) \end{equation}\]우리는 데이터가 정규 분포되어 있는 것을 볼 수 알 수 있다. 1000개의 샘플 값들의 평균을 구함으로써 평균값을 쉽게 계산가능. $\mu_{obs} = 10.098$사
사후 확률과 비례하야 하기때문에 우리는 각 데이터 포인트에 대해 다음과 같은 pdf를 선택.
\[\begin{equation} f(d_i/ \mu,\sigma^2) = \dfrac{1}{\sqrt{2\pi\sigma^2}}e^{-\dfrac{(d_i-\mu)^2}{2\sigma^2}} \end{equation}\]여기서 우리가 구할 파라미터는 $\sigma$이다. 따라서 $\mu$상수이다. $\mu=\mu_{obs}$.
Define when we accept or reject $\mu_{new}$
\[\begin{align} \dfrac{Likelihood(D/\mu_{obs},\sigma_{new})*prior(\mu_{obs},\sigma_{new})}{Likelihood(D/\mu_{obs},\sigma_{current})*prior(\mu_{obs},\sigma_{current})}>1 \end{align}\]일때 $\mu_{new}$ accept.
또한 만약 ratio 이 1보다 작거나 같으면 $U(0, 1)$에서 생성된 $u$ 난수와 비교합니다. ratio이 $u$ 난수보다 크면 $\sigma_{new}$를 받아들이고, 그렇지 않으면 거부.
사전 분포 및 가능도 정의
이전 $P(\theta)$에 대해 $\mu$가 상수이므로 $P(\sigma)$를 주목해야한다.
우리는 $\sigma$가 어떤 값을 가져야 할 지 대한 정보가 없다. 단 한가지 확실한 것은 양수한다는 점이다.
이는 $\sigma=\sqrt{\dfrac{1}{n}\sum_i^n(d_i-\mu)^2}$ 라는 수직으로 쉽게 알 수 있다.
가능도에 대해서
관측된 총 가능도는 $Likelihood(D/\mu_{obs},\sigma_{a}) = \prod_i^n f(d_i/\mu_{obs},\sigma_{a}) , where \space a=new : or : current$ 이다.
해당 케이스 경우 우리는 해당 가능도에 로그를 사용 할 것이다. 이는 계산에 간단하게 해주며 안정에 도움이 되기 때문이다.
수천 개의 작은 값 (확률, 가능도 등)을 곱하는 것은 시스템 메모리에서 언더플로우를 일으킬 수 있습니다.
log는 곱셈을 덧셈으로 변환하고 작은 양수 값을 non-small 음수 값으로 변환할 수 있다.
식 (29)번은 다음으로 전환 할 수 있다.
\[\begin{align} \begin{gathered} Log(Likelihood(D/\mu_{obs},\sigma_{new})) + Log(prior(\mu_{obs},\sigma_{new})) - \\(Log(Likelihood(D/\mu_{obs},\sigma_{current}))+ Log(prior(\mu_{obs},\sigma_{current}))) > 0 \end{gathered} \end{align}\]Equivalent to:
\[\begin{align} \begin{gathered}\sum_i^nLog(f(d_i/\mu_{obs},\sigma_{new})) + Log(prior(\mu_{obs},\sigma_{new})) \\ - \sum_i^nLog(f(d_i/\mu_{obs},\sigma_{current}))-Log(prior(\mu_{obs},\sigma_{current}))>0 \end{gathered} \end{align}\]Equivalent to:
\[\begin{align} \begin{gathered} \sum_i^n -nLog(\sigma_{new}\sqrt{2\pi})-\dfrac{(d_i-\mu_{obs})^2}{2\sigma_{new}^2} + Log(prior(\mu_{obs},\sigma_{new})) \quad > \\ \sum_i^n -nLog(\sigma_{current}\sqrt{2\pi})-\dfrac{(d_i-\mu_{obs})^2}{2\sigma_{current}^2}+Log(prior(\mu_{obs},\sigma_{current})) \end{gathered} \end{align}\]#The tranistion model defines how to move from sigma_current to sigma_new
transition_model = lambda x: [x[0],np.random.normal(x[1],0.5,(1,))[0]]
def prior(x):
#x[0] = mu, x[1]=sigma (new or current)
#returns 1 for all valid values of sigma. Log(1) =0, so it does not affect the summation.
#returns 0 for all invalid values of sigma (<=0). Log(0)=-infinity, and Log(negative number) is undefined.
#It makes the new sigma infinitely unlikely.
if(x[1] <=0):
return 0
return 1
#Computes the likelihood of the data given a sigma (new or current) according to equation (2)
def manual_log_like_normal(x,data):
#x[0]=mu, x[1]=sigma (new or current)
#data = the observation
return np.sum(-np.log(x[1] * np.sqrt(2* np.pi) )-((data-x[0])**2) / (2*x[1]**2))
#Defines whether to accept or reject the new sample
def acceptance(x, x_new):
if x_new>x:
return True
else:
accept=np.random.uniform(0,1)
# Since we did a log likelihood, we need to exponentiate in order to compare to the random number
# less likely x_new are less likely to be accepted
return (accept < (np.exp(x_new-x)))
def metropolis_hastings(likelihood_computer,prior, transition_model, param_init,iterations,data,acceptance_rule):
# likelihood_computer(x,data): returns the likelihood that these parameters generated the data
# transition_model(x): a function that draws a sample from a symmetric distribution and returns it
# param_init: a starting sample
# iterations: number of accepted to generated
# data: the data that we wish to model
# acceptance_rule(x,x_new): decides whether to accept or reject the new sample
x = param_init
accepted = []
rejected = []
for i in range(iterations):
x_new = transition_model(x)
x_lik = likelihood_computer(x,data)
x_new_lik = likelihood_computer(x_new,data)
if (acceptance_rule(x_lik + np.log(prior(x)),x_new_lik+np.log(prior(x_new)))):
x = x_new
accepted.append(x_new)
else:
rejected.append(x_new)
return np.array(accepted), np.array(rejected)
accepted, rejected = metropolis_hastings(manual_log_like_normal,prior,transition_model,[mu_obs,0.1], 50000,observation,acceptance)
fig = plt.figure(figsize=(10,10))
ax = fig.add_subplot(2,1,1)

ax.plot( rejected[0:50,1], 'rx', label='Rejected',alpha=0.5)
ax.plot( accepted[0:50,1], 'b.', label='Accepted',alpha=0.5)
ax.set_xlabel("Iteration")
ax.set_ylabel("$\sigma$")
ax.set_title("Figure 2: MCMC sampling for $\sigma$ with Metropolis-Hastings. First 50 samples are shown.")
ax.grid()
ax.legend()

ax2 = fig.add_subplot(2,1,2)
to_show=-accepted.shape[0]
ax2.plot( rejected[to_show:,1], 'rx', label='Rejected',alpha=0.5)
ax2.plot( accepted[to_show:,1], 'b.', label='Accepted',alpha=0.5)
ax2.set_xlabel("Iteration")
ax2.set_ylabel("$\sigma$")
ax2.set_title("Figure 3: MCMC sampling for $\sigma$ with Metropolis-Hastings. All samples are shown.")
ax2.grid()
ax2.legend()

fig.tight_layout()
accepted.shape
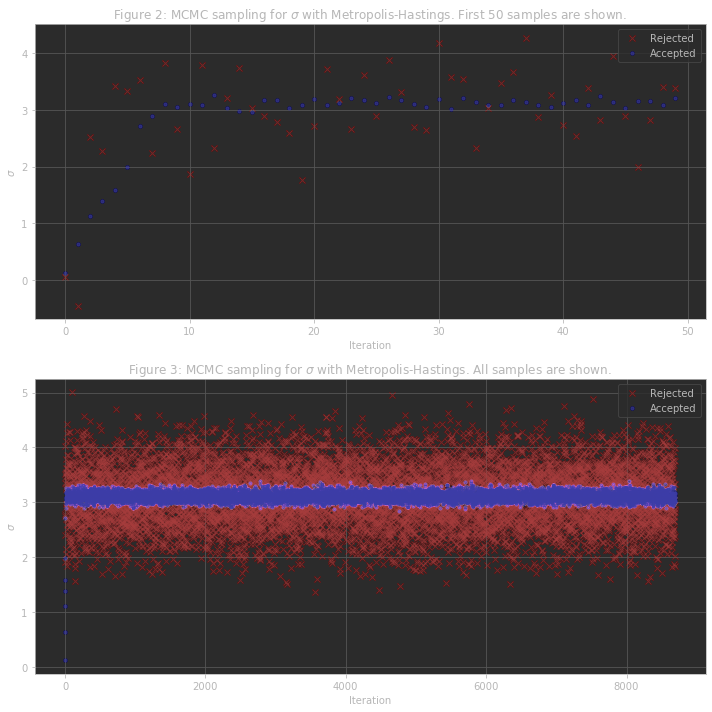
초기 σ 0.1에서 시작하여 알고리즘은 예상 값인 3으로 매우 빠르게 수렴. 에초에 1D 공간에서 샘플링이기에 놀라운 현상은 아님.
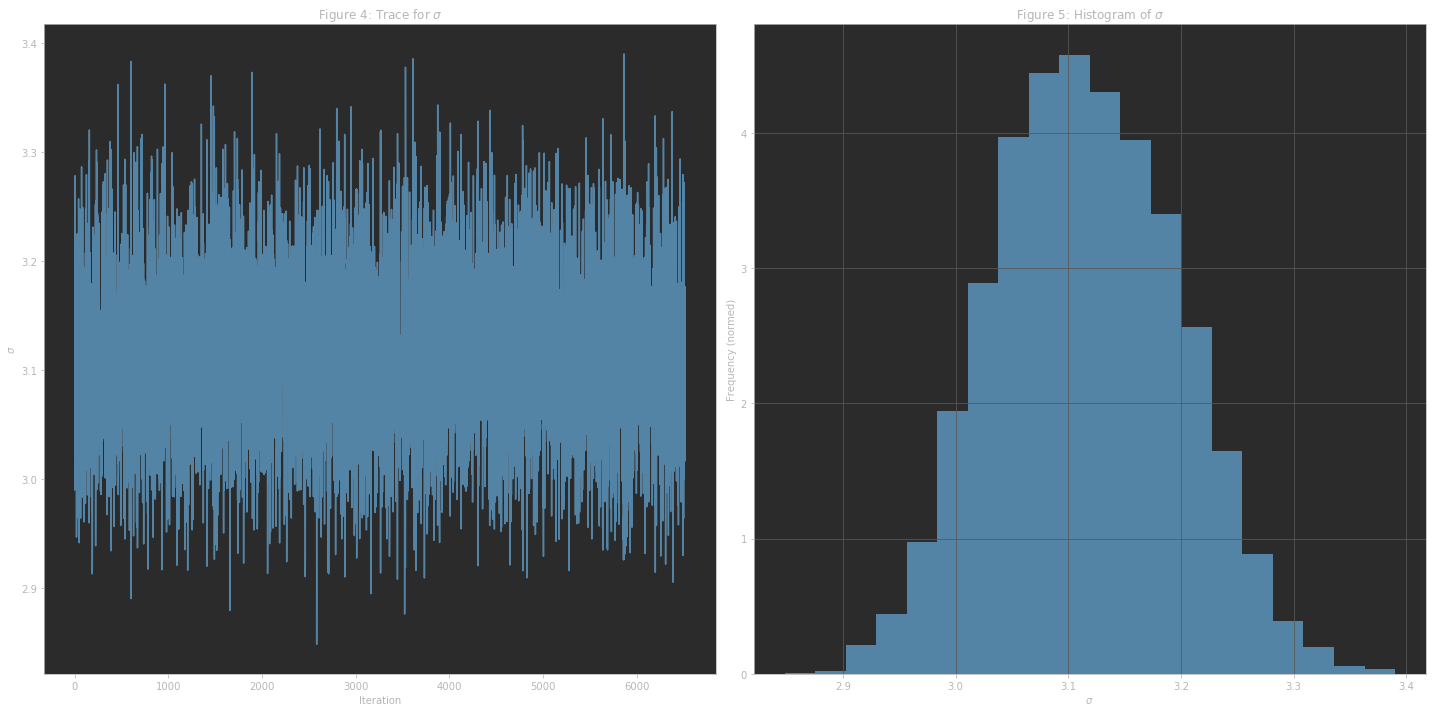
$\sigma$ 값의 초기 25%를 “burn-in”으로 간주하여 이를 삭제.
show=int(-0.75*accepted.shape[0])
hist_show=int(-0.75*accepted.shape[0])

fig = plt.figure(figsize=(20,10))
ax = fig.add_subplot(1,2,1)
ax.plot(accepted[show:,1])
ax.set_title("Figure 4: Trace for $\sigma$")
ax.set_ylabel("$\sigma$")
ax.set_xlabel("Iteration")
ax = fig.add_subplot(1,2,2)
ax.hist(accepted[hist_show:,1], bins=20,density=True)
ax.set_ylabel("Frequency (normed)")
ax.set_xlabel("$\sigma$")
ax.set_title("Figure 5: Histogram of $\sigma$")
fig.tight_layout()

ax.grid("off")
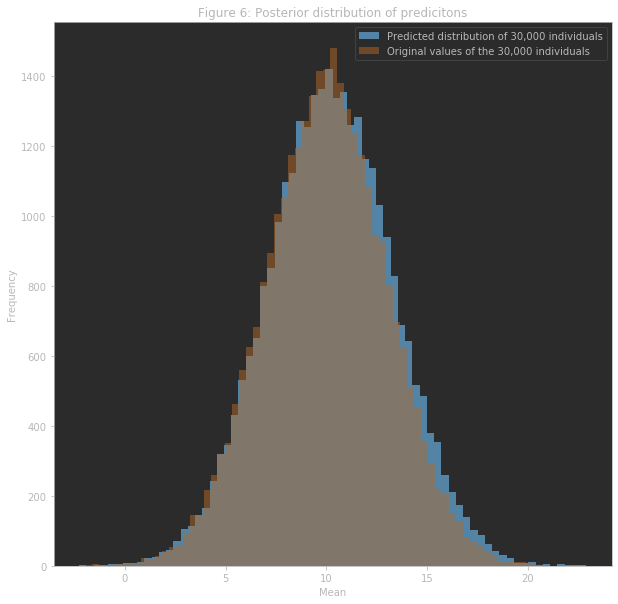
Predictions:
mu=accepted[show:,0].mean()
sigma=accepted[show:,1].mean()
print(mu, sigma)
model = lambda t,mu,sigma:np.random.normal(mu,sigma,t)
observation_gen=model(population.shape[0],mu,sigma)
fig = plt.figure(figsize=(10,10))
ax = fig.add_subplot(1,1,1)
ax.hist( observation_gen,bins=70 ,label="Predicted distribution of 30,000 individuals")
ax.hist( population,bins=70 ,alpha=0.5, label="Original values of the 30,000 individuals")
ax.set_xlabel("Mean")
ax.set_ylabel("Frequency")
ax.set_title("Figure 6: Posterior distribution of predicitons")
ax.legend()
실제 케이스 예제
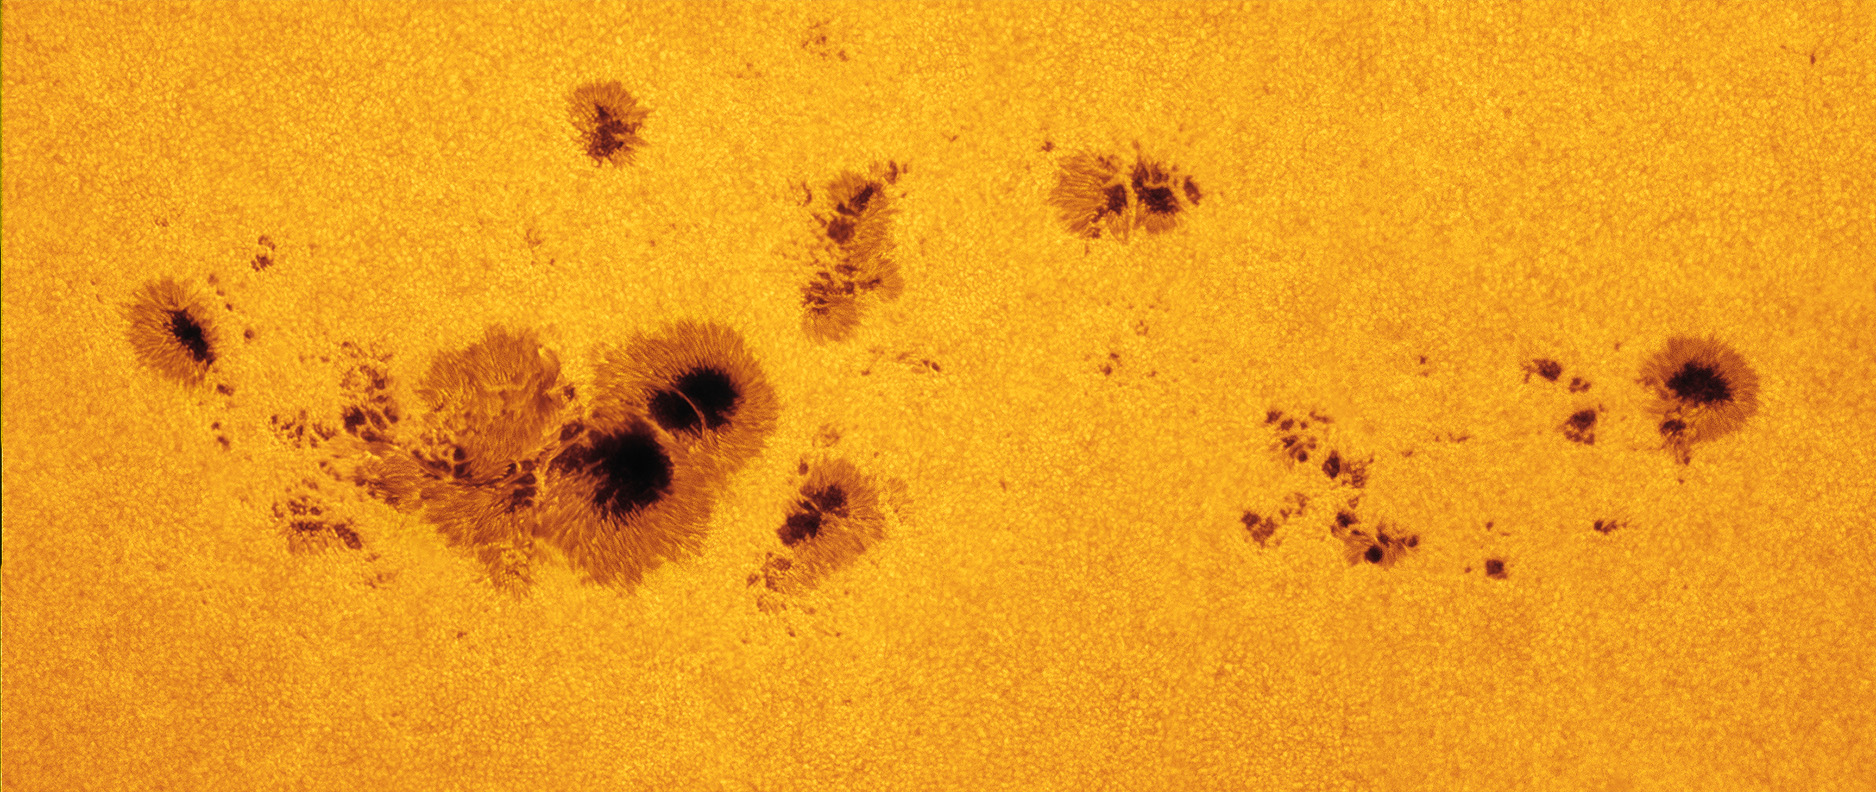
태양 흑점은 태양의 표면 (광도층)에서 주변보다 낮은 온도로 표시되는 지역이다.
이러한 온도 감소는 와류 브레이크와 유사한 효과로 대류를 억제하는 자기장 자속의 농도 때문에 발생.
태양 흑점은 일반적으로 반대 자기극성 쌍으로 나타난다. 흑점의 수는 약 11년의 태양 주기에 따라 달라진다.
우리가 작업할 데이터는 1749년 1월부터 2018년 11월까지 매달 “월간 평균 총 태양 흑점 수”이다.
해당 데이터는 국제 태양 흑점 번호의 생산, 보존 및 배포를 위한 세계 데이터 센터에서 수집, 관리 및 공개된 데이터이다.
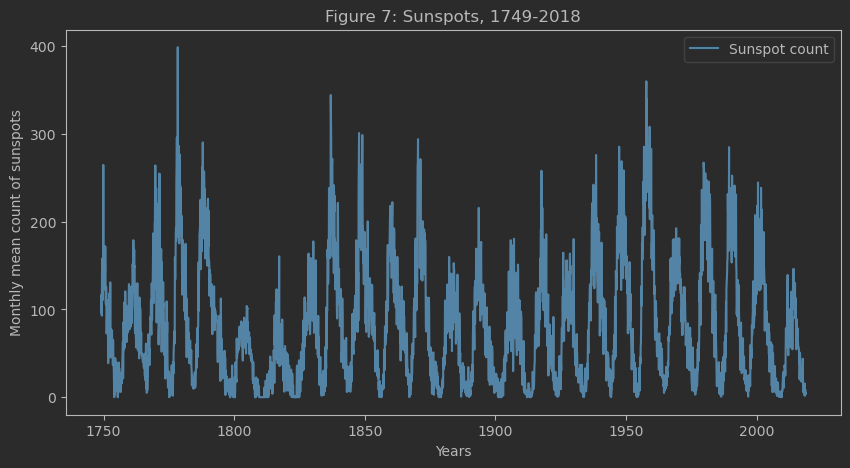
fig = plt.figure(figsize=(10,10))
ax = fig.add_subplot(1,1,1)
ax.hist(activity, bins=40, density=True)
ax.set_xlabel("Sunspot count")
ax.set_ylabel("Frequency")
ax.set_title("Figure 9: Histogram showing the frequency of sunspot counts over 270 years (1749-2018)")
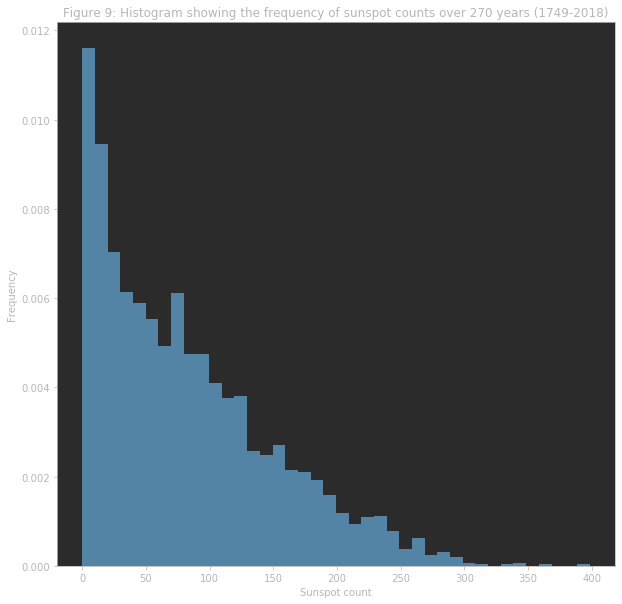
보이듯이 해당 분포는 감마 분포를 따르는 것처럼 보인다.
감마 분포는 PDF의 경우, $f/f(x;a,b) =\dfrac{b^a x^{a-1}e^{-b x}}{\Gamma{(a)}}$이며 $\Gamma$는 감마 함수이다. $\Gamma{(a)}=(a-1)!$다.
더미 데이터 예제에서 와 동일한 절차에 따라 이 pdf에서 log 가능도를 작성할 수 있다.
a와 b는 양수여야 하므로, prior에 이를 적용.
transition_model = lambda x: np.random.normal(x,[0.05,5],(2,))
import math
def prior(w):
    if(w[0]<=0 or w[1] <=0):
        return 0
    else:
        return 1

def manual_log_lik_gamma(x,data):
    return np.sum((x[0]-1)*np.log(data) - (1/x[1])*data - x[0]*np.log(x[1]) - np.log(math.gamma(x[0])))

def log_lik_gamma(x,data):
    return np.sum(np.log(scipy.stats.gamma(a=x[0],scale=x[1],loc=0).pdf(data)))
accepted, rejected = metropolis_hastings(manual_log_lik_gamma,prior,transition_model,[4, 10], 50000,activity,acceptance)
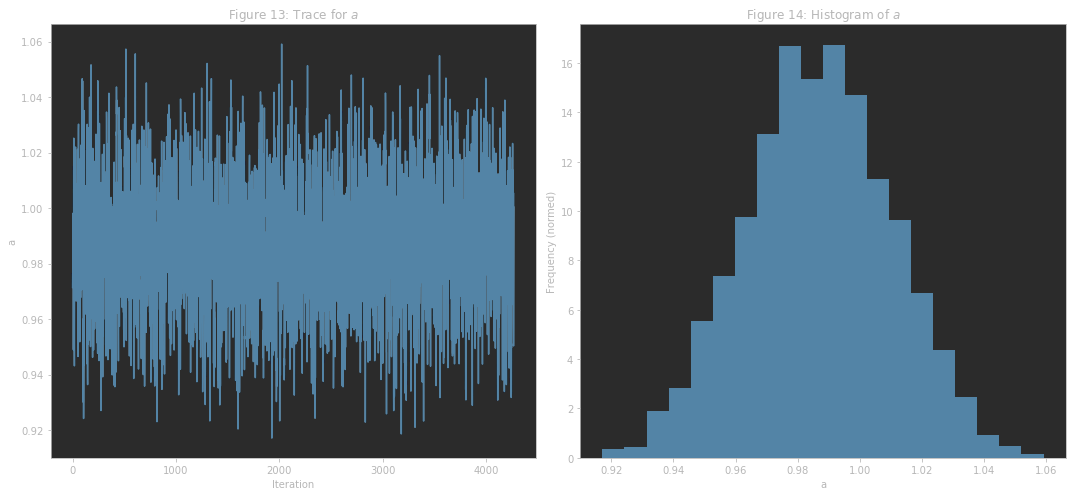
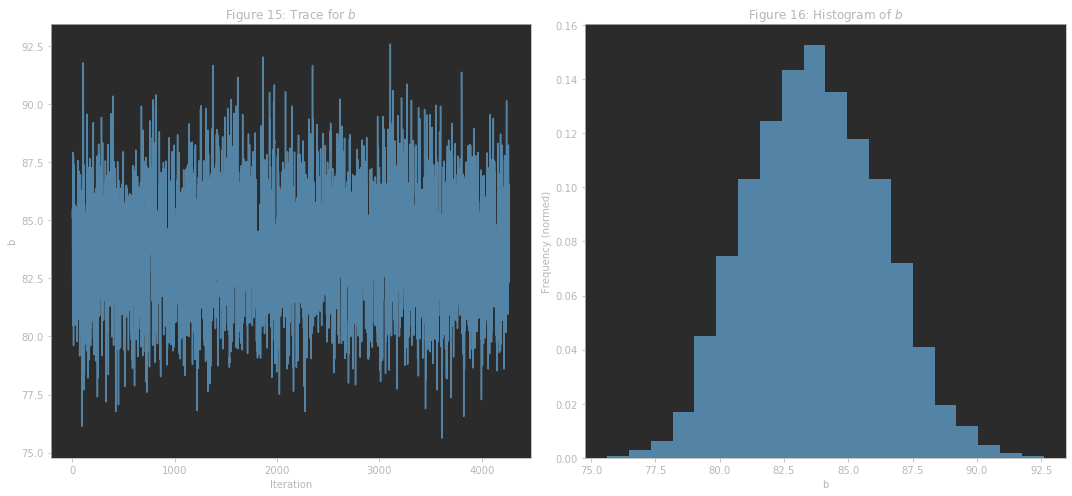
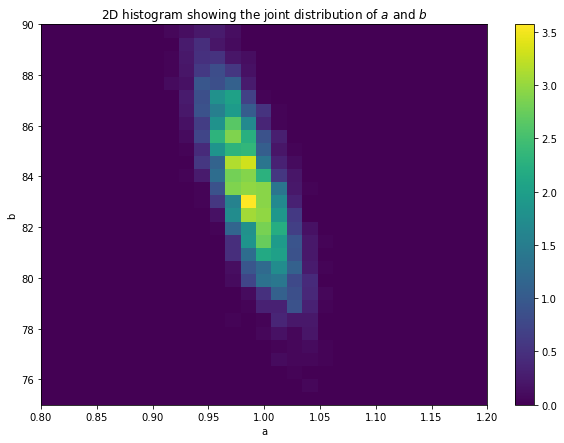
알고리즘은 a=4, b=10에서 시작하여 8561쌍의 샘플을 허용했으며, a의 마지막 값은 1.01307402, b의 마지막 값은 83.40995308로 초기 값과 상당히 차이가 발생.
print(accepted.shape)
accepted[-10:]

array([[ 0.97009904, 85.34205726],
       [ 0.97018033, 88.24737974],
       [ 0.97439353, 87.74024406],
       [ 0.97891065, 85.53414066],
       [ 0.96527862, 86.48928538],
       [ 0.98343021, 84.39404222],
       [ 1.00547929, 82.69265895],
       [ 0.95034478, 86.55690013],
       [ 0.98935646, 85.16989734],
       [ 1.00038475, 82.32425891]])
fig= plt.figure(figsize=(10,20))
ax= fig.add_subplot(3,1,1)
ax.plot(accepted[:50,0], accepted[:50,1], label="Path")
ax.plot(accepted[:50,0], accepted[:50,1], 'b.', label='Accepted')
ax.plot(rejected[:50,0], rejected[:50,1], 'rx', label='Rejected')
ax.set_xlabel("a")
ax.set_ylabel("b")
ax.legend()
ax.set_title("Figure 10: MCMC sampling for $a$ and $b$ with Metropolis-Hastings. First 50 samples are shown.")

ax= fig.add_subplot(3,1,2)
ax.plot(accepted[:,0], accepted[:,1], label="Path")
ax.plot(accepted[:,0], accepted[:,1], 'b.', label='Accepted',alpha=0.3)
ax.plot(rejected[:,0], rejected[:,1], 'rx', label='Rejected',alpha=0.3)
ax.set_xlabel("a")
ax.set_ylabel("b")
ax.legend()
ax.set_title("Figure 11: MCMC sampling for $a$ and $b$ with Metropolis-Hastings. All samples are shown.")

to_show=50
ax= fig.add_subplot(3,1,3)
ax.plot(accepted[-to_show:,0], accepted[-to_show:,1], label="Path")
ax.plot(accepted[-to_show:,0], accepted[-to_show:,1], 'b.', label='Accepted',alpha=0.5)
ax.plot(rejected[-to_show:,0], rejected[-to_show:,1], 'rx', label='Rejected',alpha=0.5)
ax.set_xlabel("a")
ax.set_ylabel("b")
ax.legend()
ax.set_title("Figure 12: MCMC sampling for $a$ and $b$ with Metropolis-Hastings. Last 50 samples are shown.")
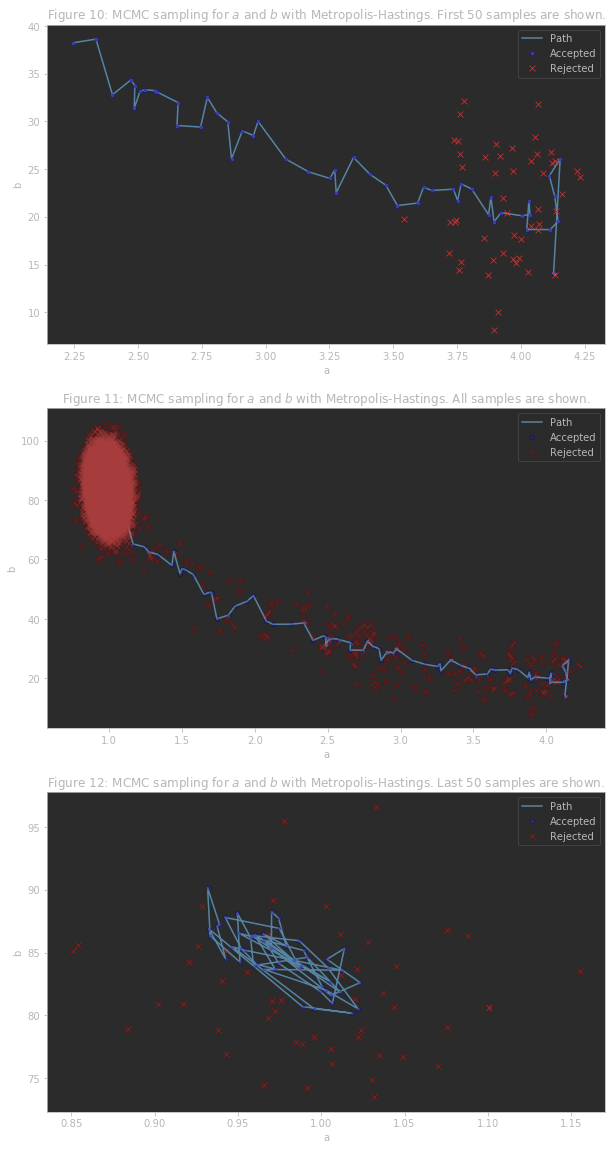
알고리즘이 샘플을 강하게 reject하기 시작할 때, 우리는 가능성의 포화 구간에 도달한 것이다.
일반적으로 이것은 우리가 샘플링 할 수 있는 최적 매개 변수 공간에 도달했다는 것으로 해석될 수 있다.
다시 말해, 알고리즘이 새로운 값을 받아 들일 이유가 거의 없다는 것이다.
그림 11과 12에서는 알고리즘이 작은 범위를 벗어나는 값들을 더이상 받아들이지 않음을 나타냄.
show=int(-0.5*accepted.shape[0])
hist_show=int(-0.50*accepted.shape[0])

fig = plt.figure(figsize=(15,7))
ax = fig.add_subplot(1,2,1)
ax.plot(accepted[show:,0])
ax.set_title("Figure 13: Trace for $a$")
ax.set_xlabel("Iteration")
ax.set_ylabel("a")
ax = fig.add_subplot(1,2,2)
ax.hist(accepted[hist_show:,0], bins=20, density=True)
ax.set_ylabel("Frequency (normed)")
ax.set_xlabel("a")
ax.set_title("Figure 14: Histogram of $a$")
fig.tight_layout()

fig = plt.figure(figsize=(15,7))
ax = fig.add_subplot(1,2,1)
ax.plot(accepted[show:,1])
ax.set_title("Figure 15: Trace for $b$")
ax.set_xlabel("Iteration")
ax.set_ylabel("b")
ax = fig.add_subplot(1,2,2)
ax.hist(accepted[hist_show:,1], bins=20, density=True)
ax.set_ylabel("Frequency (normed)")
ax.set_xlabel("b")
ax.set_title("Figure 16: Histogram of $b$")
fig.tight_layout()

fig = plt.figure(figsize=(10,7))
ax = fig.add_subplot(1,1,1)
xbins, ybins = np.linspace(0.8,1.2,30), np.linspace(75,90,30)
counts, xedges, yedges, im = ax.hist2d(accepted[hist_show:,0], accepted[hist_show:,1], density=True, bins=[xbins, ybins])
ax.set_xlabel("a")
ax.set_ylabel("b")
fig.colorbar(im, ax=ax)
ax.set_title("2D histogram showing the joint distribution of $a$ and $b$")
prediction:
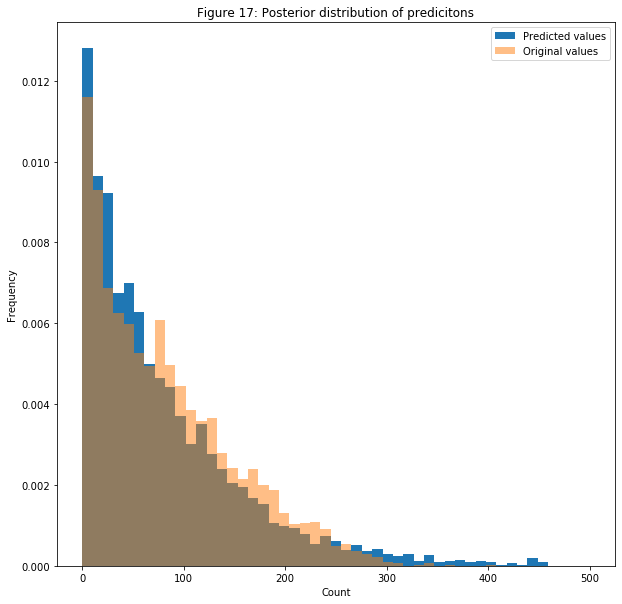
show=-int(0.5*accepted.shape[0])

mu=accepted[show:,0].mean()
sigma=accepted[show:,1].mean()
print(mu, sigma)
model = lambda t,mu,sigma:np.random.gamma(mu,sigma,t)
t=np.arange(activity.shape[0])
observation_gen=model(t.shape[0],mu,sigma)
fig = plt.figure(figsize=(10,10))
ax = fig.add_subplot(1,1,1)

ax.hist( observation_gen,bins=np.linspace(0,500,50) ,density=True,label="Predicted values")
ax.hist( activity,bins=np.linspace(0,500,50) ,alpha=0.5,density=True, label="Original values")
ax.set_xlabel("Count")
ax.set_ylabel("Frequency")
ax.set_title("Figure 17: Posterior distribution of predicitons")
ax.legend()
# 0.9867865697406477 83.71359258615742
참고 문헌
- 【蒙特卡洛(Monte Carlo, MCMC)方法的原理和应用】 https://www.bilibili.com/video/BV17D4y1o7J2/?share_source=copy_web&vd_source=8143554ab30ed4cd174db3b275992f7d
- 【[硬核系列] 蒙特卡洛模拟与MCMC】 https://www.bilibili.com/video/BV1qR4y1J7ht/?share_source=copy_web&vd_source=8143554ab30ed4cd174db3b275992f7d
- Markov Chain Monte Carlo - 공돌이의 수학정리노트